イェンゼンの不等式とは?Aiと統計学を支える超重要定理を徹底解説
理論上は極めて簡明なイェンゼンの不等式ですが、AI開発や機械学習エンジニアの実務現場では、実装時の符号の取り違えによる学習破綻が後を絶ちません。
技術コミュニティ(GitHubのIssueや技術ブログ等)で報告される典型的なトラブルが、損失関数(Loss Function)の設計ミスです。
機械学習フレームワーク(PyTorchやTensorFlow)では通常「損失を最小化」するため、負の対数尤度(Negative Log-Likelihood)を扱います。このとき、関数が凸か凹かの判定を誤り、ELBOの符号を反転させる段階で不等号の向きと最適化の方向が噛み合わなくなる事例が多発しています。
- 正常なケース:真の尤度 $\ge \mathrm{ELBO}$ なので、$\mathrm{ELBO}$ を最大化(あるいは $-\mathrm{ELBO}$ を最小化)すれば真のモデル性能が引き上げられる。
- 破綻したケース:符号を間違えて「上界」を最小化してしまうと、真の尤度をどこまでも押し下げてしまい、モデル出力が完全に崩壊(Posterior CollapseやNaNの発生)する。
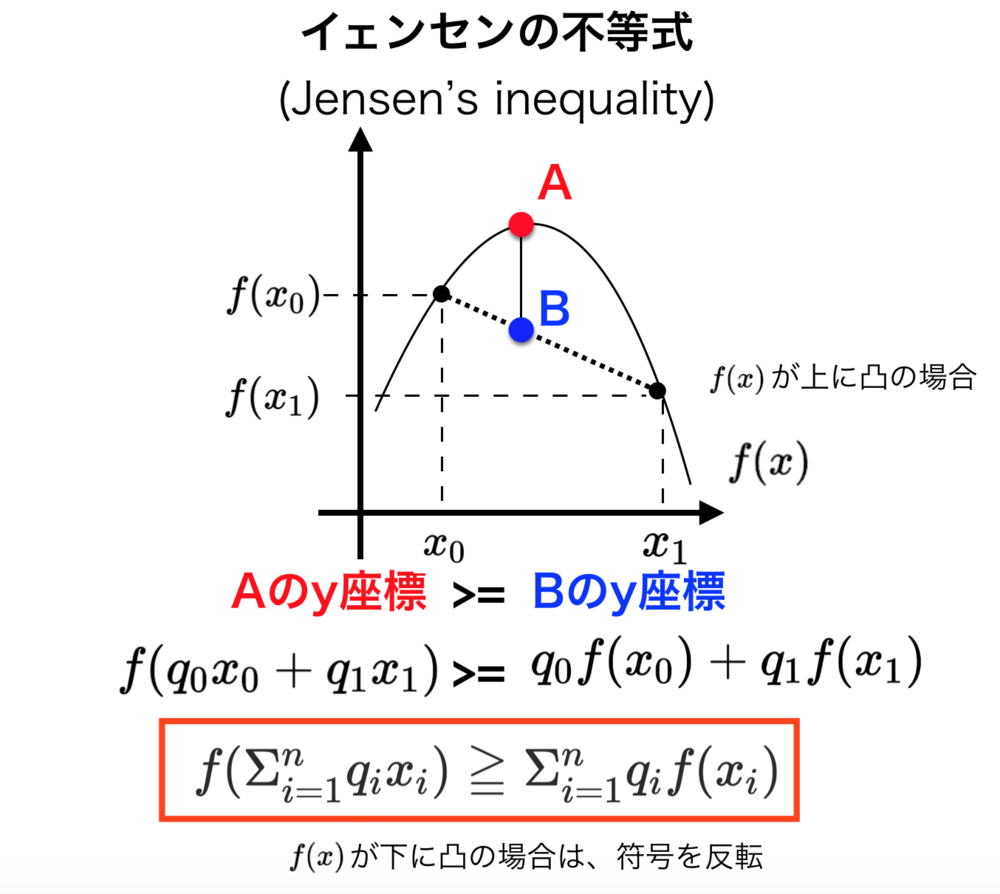
トップカンファレンスに採択される先端論文であっても、変分近似の導出ステップでイェンゼンの不等式の不等号の向きが逆転しており、査読段階でリジェクトされるケースが散見されます。「凸なら下側、凹なら上側」という幾何学的な大原則を身体感覚として定着させておくことが、実務でのバグ防止に直結します。